Blogartikel
Prognoseverfahren auswählen: Welche Daten, Muster und Tests entscheiden?
Für denselben Artikel liegen drei Zahlen auf dem Tisch: eine Excel-Prognose, eine Systemprognose und die Schätzung des Vertriebs, und sie weichen voneinander ab. Hier lesen Sie, wie Sie Prognoseverfahren für einen Artikel auswählen und fair gegeneinander testen.

Welches Prognoseverfahren zu einem Artikel passt, folgt aus der Information, die zum Prognosezeitpunkt vorliegt: Absatzhistorie, geplante Aktionen, vergleichbare Artikel oder das Wissen der Fachleute. Daraus ergeben sich Kandidaten. Welcher sich bewährt, zeigt erst ein fairer Test gegen eine einfache Prognose wie den Wert der Vorwoche.
Prognoseverfahren schätzen die künftige Nachfrage. Qualitative Verfahren stützen sich auf Erfahrung und Expertenwissen, quantitative rechnen mit Daten: der eigenen Absatzhistorie, zusätzlich Einflussgrößen wie Aktionen, Preisen oder Feiertagen oder den Daten ähnlicher Artikel. Welches Verfahren für einen Artikel trägt, zeigt ein Test gegen eine einfache Vergleichsprognose.
Prognoseverfahren: Definition und Einteilung nach Information
Das Gabler Wirtschaftslexikon teilt Prognoseverfahren in zwei Gruppen. Quantitative Verfahren beruhen auf mathematischen Verfahren, etwa Trendextrapolation oder exponentiellem Glätten. Qualitative Verfahren beruhen auf Erfahrungen, Kenntnissen und Fingerspitzengefühl und kommen zum Einsatz, wenn quantitative Daten fehlen, etwa als Delphi-Technik oder Expertenbefragung. Hyndman und Athanasopoulos (2021) halten in ihrem Lehrbuch Forecasting: Principles and Practice fest, dass die passenden Verfahren vor allem davon abhängen, welche Daten verfügbar sind.
Eine Zeitreihenprognose schätzt eine Größe nur aus ihren eigenen Werten der Vergangenheit; Gabler nennt das eine direkte Prognose. Solche Verfahren schreiben nach Hyndman und Athanasopoulos Trend und Saison fort, lassen aber alle übrige Information außer Acht, etwa Marketingaktionen. Wichtig ist dabei, was in der Reihe steht: Prognostiziert werden soll die Nachfrage, in den Daten steht der verbuchte Absatz. In einer ausverkauften Woche ist das nicht dasselbe.
Nach der Information, die ein Verfahren nutzt, ergeben sich vier Stufen. Sie überschneiden sich und sind keine getrennten Klassen:
Informationsbasis | Beispiele | sieht eine geplante Aktion? | Fundstelle |
|---|---|---|---|
Urteil (qualitativ) | Expertenschätzung, Delphi, Analogie durch Fachleute | ja, wenn bekannt | Hyndman & Athanasopoulos, Gabler |
eigene Absatzhistorie | naive und saisonal naive Prognose, gleitender Durchschnitt, Glättung, ARIMA, Croston; maschinelles Lernen je Reihe | nein | Hyndman & Athanasopoulos, Petropoulos u. a. |
zusätzlich Einflussgrößen | Regression, dynamische Regression; maschinelles Lernen mit Einflussgrößen | ja, wenn vorab als Daten erfasst | Hyndman & Athanasopoulos |
andere Artikel, zusätzlich oder statt eigener Historie | vergleichbare Artikel bei Neulistung; maschinelles Lernen über viele Artikel | je nach Modell | Petropoulos u. a. |
Dieselbe Modellfamilie kann mehrere Stufen nutzen. Statistische Verfahren und maschinelles Lernen lassen sich nach Petropoulos u. a. (2022) nicht ohne Weiteres trennen, und Regression wird ebenso auf Zeitreihen angewandt; Hyndman und Athanasopoulos widmen den Regressionsmodellen für Zeitreihen ein eigenes Kapitel. Verfahren, die den Bedarf aus dem Verbrauch der Vergangenheit schätzen, heißen in der Materialwirtschaft auch Verfahren der stochastischen Bedarfsermittlung.
Prognoseverfahren im Überblick: Beispiele je Informationsbasis
Je Stufe ein kurzer Überblick, mit dem, was das Verfahren voraussetzt.
Urteil. Hyndman und Athanasopoulos beschreiben drei Lagen für urteilsbasierte Prognosen: Es liegen keine Daten vor; es liegen Daten vor, und die statistische Prognose wird mit Urteil angepasst; oder statistische und urteilsbasierte Prognose entstehen unabhängig und werden kombiniert. Dazu gehören die Delphi-Methode, die Analogie zu früheren Fällen und die Einschätzung des Vertriebs. Im FMCG ist das ein Weg bei einer Neulistung ohne eigene Historie oder wenn die Historie nach einem Sortimentswechsel nicht mehr passt.
Eigene Absatzhistorie. Die einfachsten Verfahren sind die naive Prognose, die den letzten Wert fortschreibt, und die saisonal naive Prognose, die den Wert derselben Saison im Vorjahr nimmt. Manchmal ist eine dieser einfachen Prognosen nach Hyndman und Athanasopoulos selbst das beste verfügbare Verfahren, in vielen Fällen dient sie als Vergleichsmaßstab: Schlägt ein neues Verfahren sie im fairen Test nicht, lohnt es sich nicht. Der gleitende Durchschnitt mittelt den Verbrauch der letzten Perioden, laut Gabler als arithmetisches Mittel der letzten n Perioden; die exponentielle Glättung gibt jüngeren Werten mehr Gewicht als älteren. ARIMA-Modelle beschreiben, wie ein Wert von früheren Werten der Reihe abhängt, und für sporadischen Bedarf gibt es das Verfahren nach Croston. Wie diese Verfahren in der Praxis eines Mittelständlers aussehen, zeigt der Artikel zur Absatzprognose im Mittelstand, wie Saison abgebildet wird, der Artikel zur Saisonalität.
Zusätzlich Einflussgrößen. Regressionsmodelle erklären den Absatz über Einflussgrößen, etwa über eine Variable für Feiertage. Hyndman und Athanasopoulos nennen das ein erklärendes Modell und halten fest, dass die künftigen Werte dieser Größen bekannt sein oder selbst prognostiziert werden müssen. Kalendervariablen sind im Voraus bekannt; eine Aktion oder Preisänderung nur so, wie sie zum Prognosezeitpunkt geplant ist. Das Wetter der Aktionswoche dagegen muss selbst prognostiziert werden. Wie Aktionen in die Prognose kommen, zeigt der Artikel zu Promotions in der Absatzprognose.
Zusätzlich andere Artikel. Für neue Produkte nennen Petropoulos u. a. in der Übersicht Forecasting: theory and practice Ansätze, die Analogien suchen und vergleichbare Produkte nutzen.
Maschinelles Lernen kann Zusammenhänge aus Daten lernen und, je nach Modellaufbau, Informationen aus mehreren Artikeln und zusätzlichen Einflussgrößen nutzen. Dafür braucht es nach Petropoulos u. a. ausreichend Daten und erheblichen Aufwand für die Einrichtung. Wann sich das im Mittelstand rechnet, behandelt der Artikel zur KI-Absatzprognose.

Prognoseverfahren auswählen: prüfen, Kandidaten wählen, fair testen
Die Auswahl folgt drei Schritten in fester Reihenfolge: erst die Daten prüfen, dann aus der verfügbaren Information Kandidaten ableiten, zuletzt die Kandidaten unter gleichen Bedingungen testen.
Erst prüfen: Ist der verbuchte Absatz die Nachfrage?
Bevor ein Verfahren gewählt wird, gehört die Absatzreihe geprüft. Fehlbestände, Datenlücken, Aktionen und Brüche wie eine verlorene Listung werden markiert. Ein Verfahren ohne Einflussgrößen liest eine Aktionswoche als normale Nachfrage, solange sie nicht bereinigt ist; ein Verfahren mit Einflussgrößen kann den Mehrabsatz nur einer Aktion zuordnen, die in den Daten markiert ist. Unmarkierte Fehlbestände können Verfahren verzerren, die den verbuchten Absatz als tatsächliche Nachfrage interpretieren: Eine ausverkaufte Aktionswoche zeigt weniger Absatz, als nachgefragt war, eine Teilbelieferung ohne Nachlieferung ebenso.
Die Prüffrage: War die Ware in den Nullwochen lieferbar, und sind alle Aufträge gebucht? Eine Woche mit null Absatz ist nur dann eine Woche ohne Nachfrage, wenn beides zutrifft. Wie Fehlmengen aus der Historie herausgerechnet werden, zeigt der Artikel zur Stockout-Verzerrung.
Dann Kandidaten wählen: Welche Information liegt vorab vor?
Welche Verfahren infrage kommen, klären vier Fragen:
Gibt es eine Absatzhistorie, die auch für die kommenden Wochen gilt, und zeigt sie Saison oder Trend?
Liegen planbare Einflüsse wie Aktionen, Preisänderungen oder Feiertage vorab als Daten vor?
Gibt es vergleichbare Artikel, deren Daten sich nutzen lassen?
Ist die Nachfrage echt sporadisch, mit Nullwochen, in denen die Ware verfügbar war?
Das Ergebnis sind Kandidaten, keine Entscheidung.
Für eine Neulistung ohne Historie ist das Urteil nach Hyndman und Athanasopoulos meist die einzige verfügbare Methode; Petropoulos u. a. nennen daneben datenbasierte Ansätze über vergleichbare Artikel. Wie sich Neuartikel und Auslaufprodukte planen lassen, zeigt der Artikel zu Neuartikeln in der Absatzprognose.
Für einen Langsamdreher mit echten Nullwochen, der nicht ausläuft, kommt ein Verfahren für sporadischen Bedarf wie Croston infrage. Die einfache Glättung ist nach Petropoulos u. a. nach einer Periode mit Bedarf nach oben verzerrt, weil sie Abstand und Menge des Bedarfs nicht trennt.
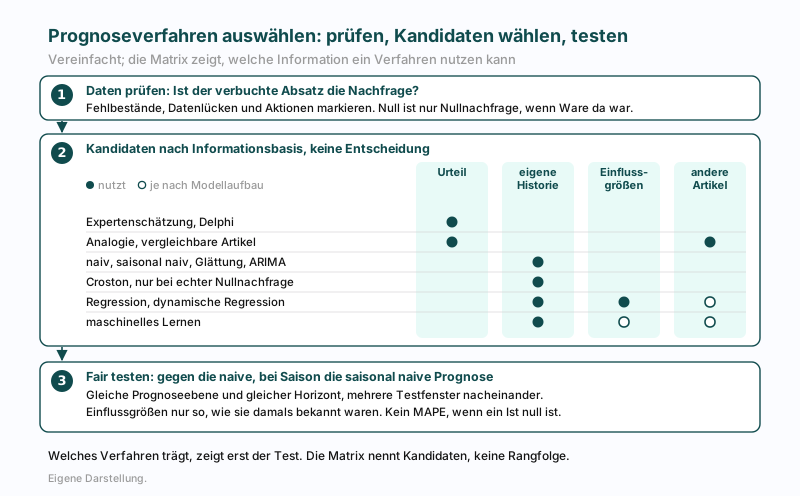
Die Grafik ist vereinfacht: Die Matrix zeigt, welche Information ein Verfahren nutzen kann, nicht welches besser ist.
Zuletzt testen: gleiche Ebene, gleicher Horizont, nur damaliges Wissen
Ein Vergleich ist nur fair, wenn alle Kandidaten unter denselben Bedingungen antreten. Fünf Regeln gehören dazu:
Gleiche Ebene, gleicher Horizont: Alle Kandidaten prognostizieren dieselben Artikel und Wochen mit demselben Vorlauf, etwa der Wiederbeschaffungszeit plus dem Abstand bis zur nächsten Bestellung. Eine Prognose für die Warengruppe kann genauer wirken als eine für den einzelnen Artikel, weil sich Abweichungen der Artikel dort ausgleichen können; gemessen wird deshalb auf der Ebene, auf der disponiert wird.
Mehrere Testfenster: Nicht ein Zeitraum, sondern mehrere aufeinanderfolgende, die auch Aktions- und Saisonwochen enthalten, und jedes Fenster nur mit Daten, die davor lagen. So beschreiben es Hyndman und Athanasopoulos für Prognosen auf Zeitreihen.
Nur damaliges Wissen: Einflussgrößen gehen nur so ein, wie sie zum Prognosezeitpunkt bekannt waren: der damalige Aktionsplan, nicht die gelaufene Aktion. Wer im Test das tatsächliche Wetter statt der damaligen Wetterprognose einsetzt, erstellt nach Hyndman und Athanasopoulos keine echte Prognose.
Gegen eine einfache Prognose: Jeder Kandidat tritt gegen die naive Prognose an, bei Saison und mindestens einem Jahr Historie gegen die saisonal naive.
Passendes Fehlermaß: Enthält der Testzeitraum ein Ist von null, ist der MAPE nicht definiert, bei Werten nahe null wird er extrem. Welche Fehlermaße sich eignen, zeigt der Artikel zur Forecast Accuracy.
Ohne verwertbare eigene Historie, etwa bei einer Neulistung oder nach einer verlorenen Listung, lässt sich am Artikel selbst nicht testen. Dann zählt, wie die Kandidaten bei früheren vergleichbaren Fällen abgeschnitten haben. Das setzt voraus, dass die damaligen Prognosen aufbewahrt wurden, auch die des Vertriebs; Hyndman und Athanasopoulos empfehlen, Prognosen aufzuzeichnen und mit den später eintretenden Werten abzugleichen.
Ein allgemein bestes Verfahren gibt es nach Petropoulos u. a. nicht, es hängt von den Daten ab, die prognostiziert werden. Die Prüffrage: Hätte das Verfahren im Test Wissen gehabt, das zum Prognosezeitpunkt fehlte?
Mit Circly: Prognosen mit Kalender, Aktionen und Fehlbestandsperioden
Circly Absatzprognosen liefert KI-generierte Absatzprognosen auf Artikelebene, die Saisonalität, Trends, Kalendereffekte, Feiertage, Aktionen und Ausreißer automatisch einbeziehen, ohne manuelle Datenpflege durch den Kunden. Fehlbestandsperioden in der Historie werden gesondert behandelt und nicht als Nullnachfrage gewertet. Das setzt voraus, dass das ERP Bestandsverlauf oder Verkaufsstatus des Artikels liefert. Aktionen und Sonderereignisse können manuell hinterlegt werden und fließen direkt ins Modell ein. Die Prognosen werden täglich auf Basis aktueller ERP-Daten via API aktualisiert, ohne manuellen Datenexport und ohne Medienbruch.
Fazit
Nicht das raffinierteste Verfahren trägt, sondern das, das die vorab verfügbare Information nutzt und den fairen Test besteht. Zuerst wird die Absatzreihe geprüft, denn ein Verfahren lernt nur die Nachfrage, die in der Reihe steht. Dann wird gefragt, welche Information vor dem Prognosezeitpunkt vorliegt, und daraus werden Kandidaten. Erst der Test gegen die naive Prognose, auf derselben Ebene und mit demselben Vorlauf, zeigt, ob ein aufwendigeres Verfahren für diesen Artikel genauer ist.
Weiterführende Quellen
Hyndman, R. J. & Athanasopoulos, G. (2021): Forecasting: Principles and Practice, 3. Auflage, OTexts
Gabler Wirtschaftslexikon, Wübbenhorst, K. u. a. (2018): Prognose
Gabler Wirtschaftslexikon, Holland, H. u. a. (2018): gleitende Mittelwerte
FAQ
Welche Prognoseverfahren gibt es?
Prognoseverfahren lassen sich nach der Information einteilen, die sie nutzen: Urteil von Fachleuten, die eigene Absatzhistorie, zusätzlich Einflussgrößen wie Aktionen und Feiertage oder zusätzlich die Daten anderer Artikel. Beispiele sind Expertenschätzung und Delphi, naive Prognose, gleitender Durchschnitt, exponentielle Glättung, ARIMA, Croston, Regression und maschinelles Lernen. Dieselbe Modellfamilie kann mehrere dieser Informationsquellen nutzen.
Was unterscheidet qualitative und quantitative Prognoseverfahren?
Qualitative Prognoseverfahren beruhen auf Erfahrung, Kenntnissen und Einschätzung, etwa als Expertenbefragung oder Delphi-Technik, und kommen zum Einsatz, wenn passende Daten fehlen, oder ergänzen eine statistische Prognose um Wissen, das nicht in den Daten steht. Quantitative Prognoseverfahren rechnen mit Daten, mit der Absatzhistorie und je nach Verfahren mit Einflussgrößen oder Daten vergleichbarer Artikel.
Was ist eine Zeitreihenprognose?
Eine Zeitreihenprognose im engeren Sinn schätzt eine Größe nur aus ihren eigenen Werten der Vergangenheit, etwa den Absatz eines Artikels aus seinem bisherigen Wochenabsatz. Sie schreibt Trend und Saison fort, berücksichtigt aber keine anderen Informationen wie geplante Aktionen. Beispiele sind naive Prognose, gleitender Durchschnitt, exponentielle Glättung und ARIMA.
Welches Prognoseverfahren ist das beste?
Ein allgemein bestes Prognoseverfahren gibt es nicht; welches trägt, hängt von den Daten des Artikels ab. Kandidaten ergeben sich aus der Information, die vorab vorliegt. Welcher davon trägt, zeigt, wo eine Historie vorliegt, ein Test auf mehreren Zeitfenstern gegen eine einfache Vergleichsprognose, mit demselben Horizont und nur dem Wissen, das zum Prognosezeitpunkt vorlag.